Todo POC de RAG (Retrieval-Augmented Generation) funciona impressionantemente bem com 20 documentos de teste, perguntas óbvias e uma demo controlada para a diretoria. O problema aparece quando a base de conhecimento real tem 40 mil páginas, os documentos têm formatação inconsistente, e uma resposta errada custa confiança do cliente — não só uma risada no Slack do time.
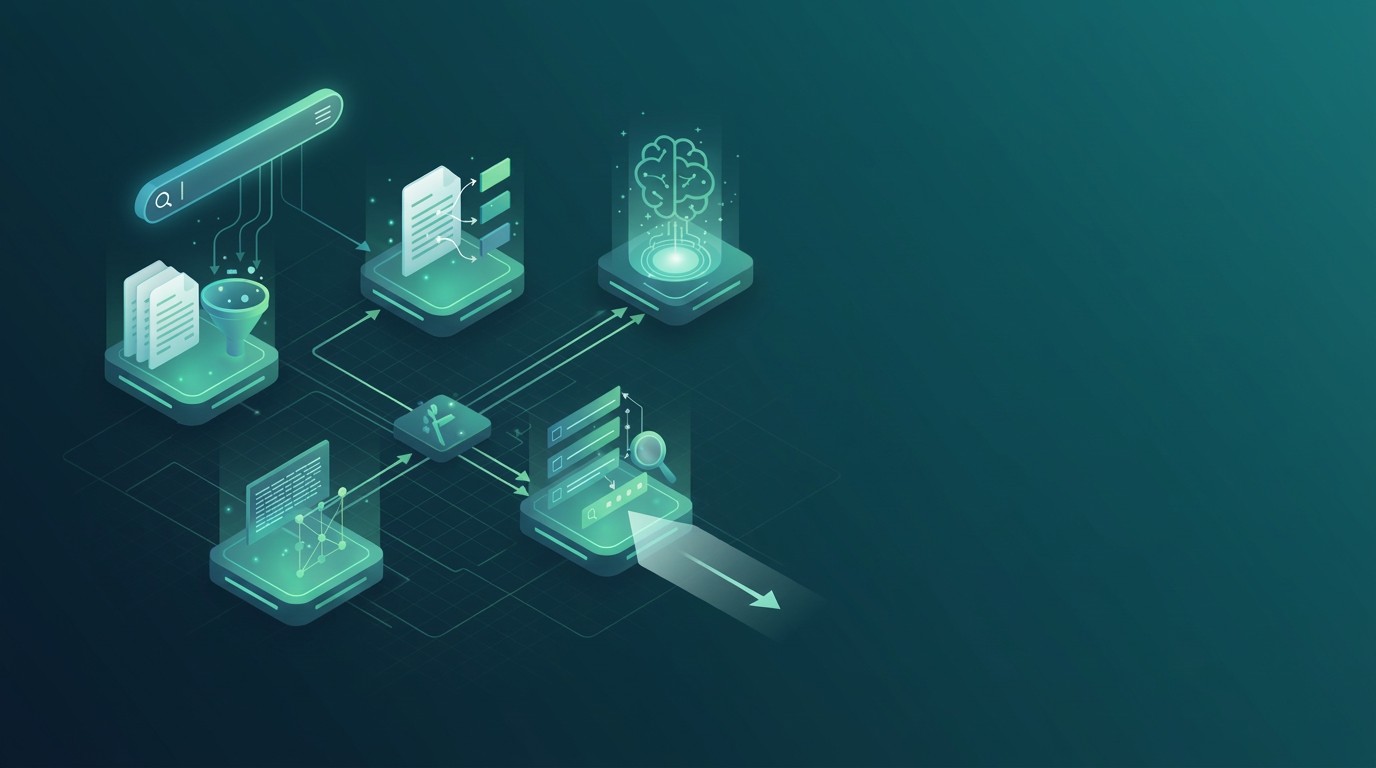
A diferença entre um RAG de demo e um RAG de produção está em cinco decisões de pipeline que raramente aparecem nos tutoriais introdutórios.
1. Chunking não é só "dividir por tamanho fixo"
Cortar documentos em blocos de 500 tokens, sem respeitar estrutura, quebra frases no meio e separa uma pergunta da sua resposta em chunks diferentes — o que faz o modelo recuperar contexto incompleto. Chunking por estrutura semântica (parágrafo, seção, tabela) preserva a unidade de sentido, mesmo que o tamanho final varie.
2. Embeddings genéricos erram em domínio técnico
Um modelo de embedding generalista entende bem linguagem natural do dia a dia, mas tem dificuldade em diferenciar termos técnicos específicos do seu domínio — nomes de produto, siglas internas, jargão regulatório. Fine-tuning ou embeddings especializados no domínio reduzem drasticamente a taxa de recuperação de documento irrelevante.
Um RAG que recupera o documento errado com alta confiança é mais perigoso do que um RAG que admite não saber. O segundo erra visivelmente; o primeiro erra com aparência de certeza.
3. Re-ranking: o passo que a maioria dos POCs ignora
Busca vetorial pura devolve os top-K documentos mais similares — mas "similar" não é o mesmo que "relevante para responder esta pergunta específica". Um passo de re-ranking, usando um modelo treinado especificamente para julgar relevância, reordena esses candidatos antes de montar o contexto final. Esse passo, sozinho, costuma melhorar a precisão percebida mais do que qualquer ajuste fino no modelo de geração.
4. Metadados são tão importantes quanto o texto
Data do documento, departamento responsável, nível de confidencialidade, versão — sem esses metadados indexados junto com o embedding, o sistema não tem como filtrar um documento desatualizado de 2022 quando existe uma versão de 2026 mais recente cobrindo o mesmo tópico.


